XPATH
Duy Văn | 8/1/2025
Problems
Bây giờ, bạn đã biết có một số lệnh cơ bản để tương tác với trình duyệt, giả sử như bạn nhìn thấy ở trang web này, một trang web chỉ có một dòng to đùng “You spelled it wrong”
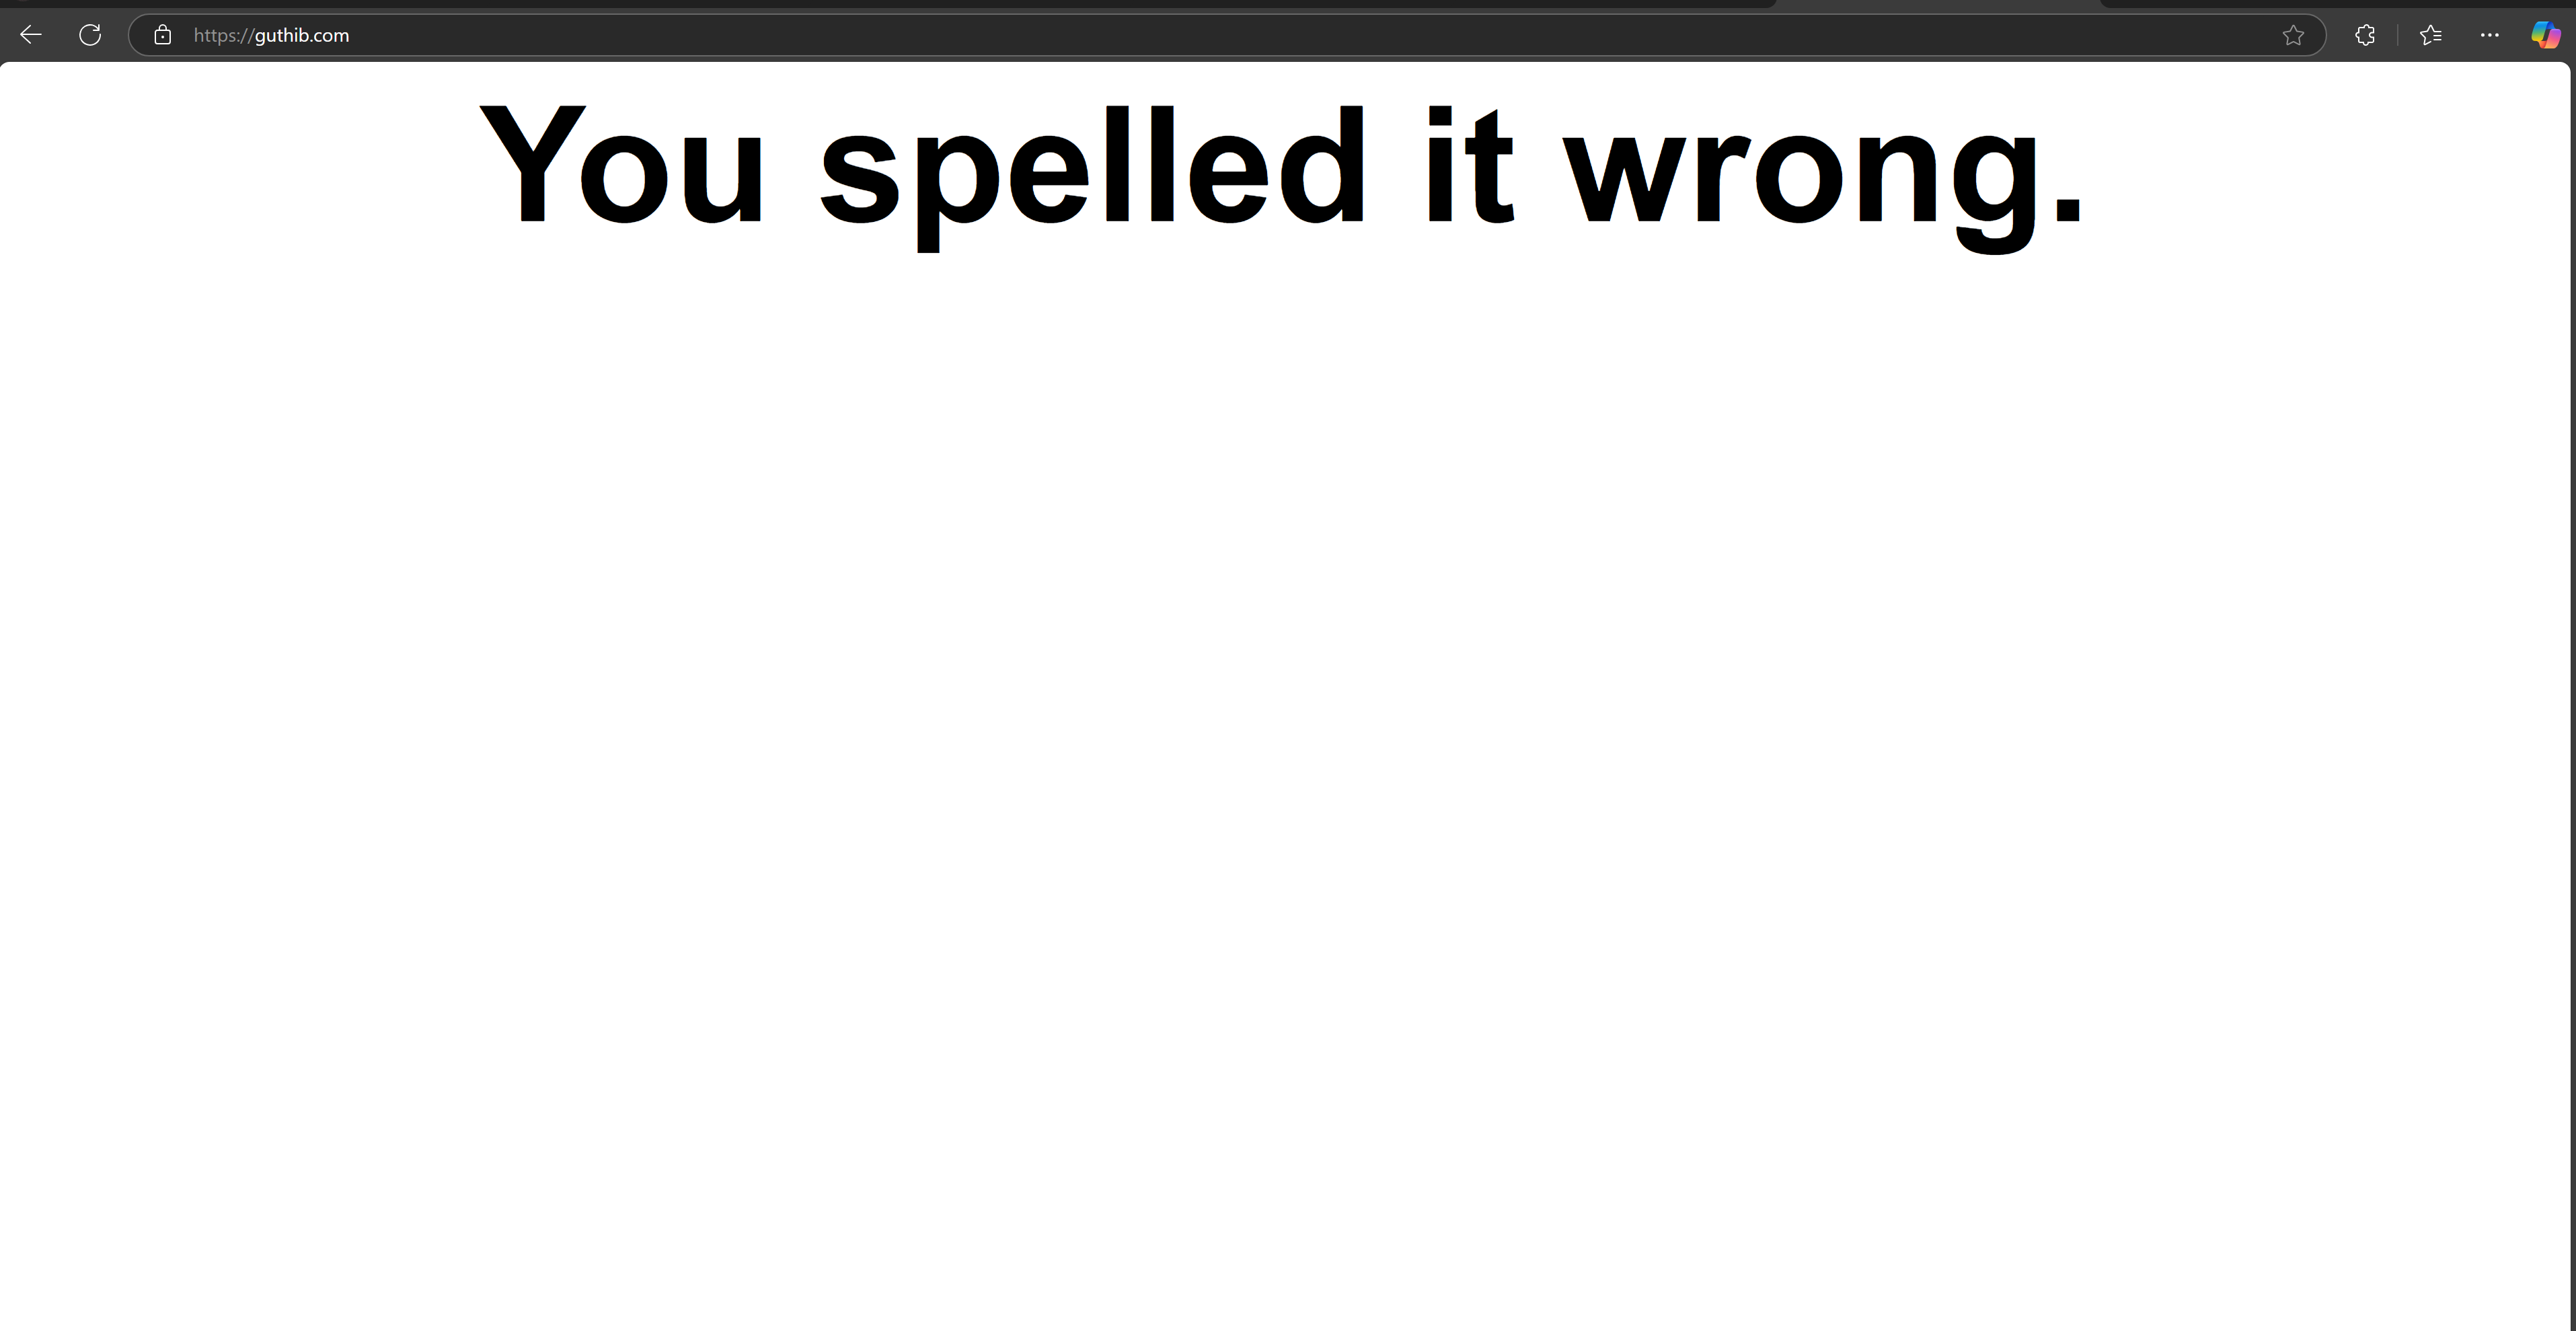
Trang web Guthib
Làm thế nào để bạn xác định được trang web này có một dòng chữ “You spelled it wrong” mà không cần phải nhìn vào trang web đó, mà chỉ cần dựa vào code HTML của trang web đó?
Hãy thử dùng một keyword của SeleniumLibrary Page Should Containt Element
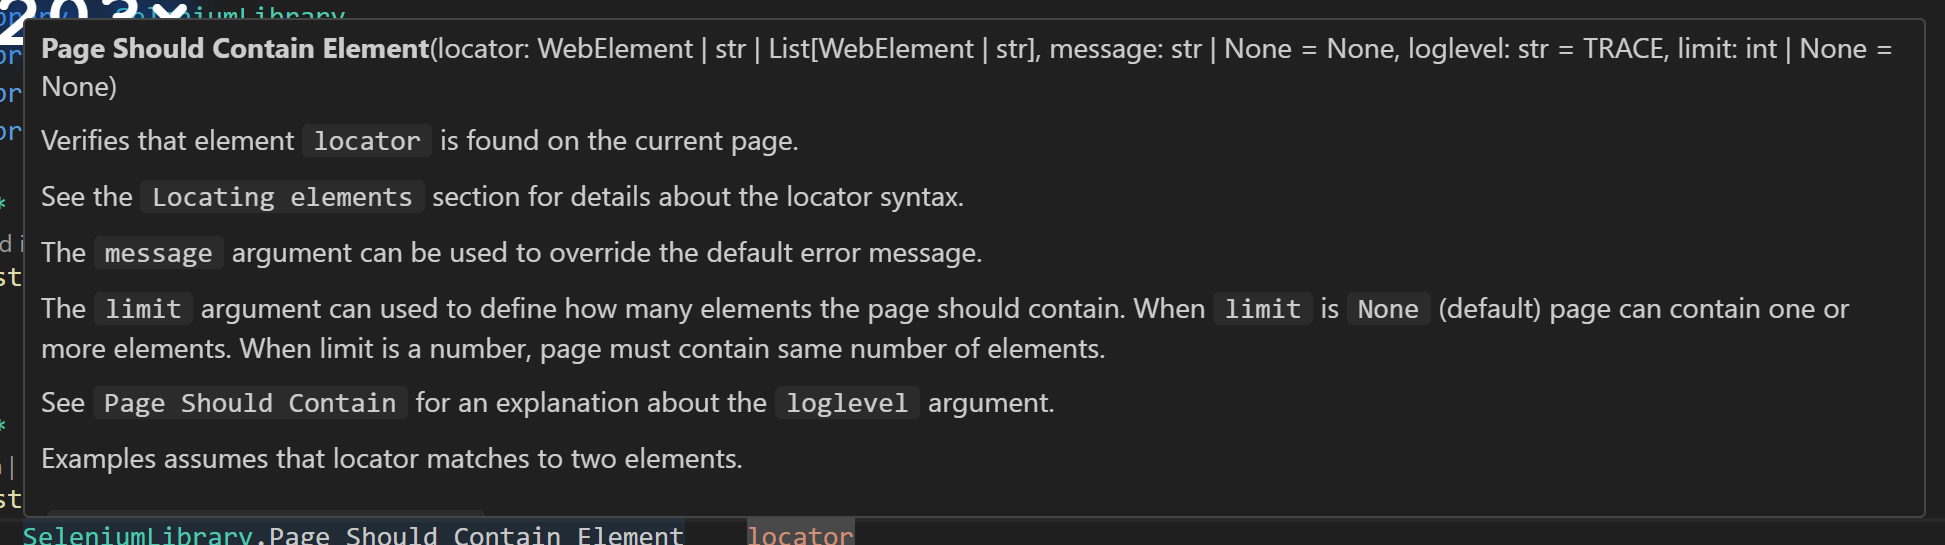
Doc của keyword
Đọc Doc của keyword trên, bạn sẽ thấy có một argument là locator : WebElement, vậy phải pass giá trị gì vào đây để kiểm tra được trong trang web có một dòng chữ “You spelled it wrong” hay không?
Đáp án là sử dụng locator như doc đã yêu cầu, vậy locator của một Web Element là gì?
<h1>You spelled it wrong.</h1>
Đây là element HTML của trang web, locator có thể được hiểu là một đường dẫn để giúp framework tìm kiếm element đó trong cấu trúc của trang web, và XPath chính là một trong những cách để xác định locator của một element
DOM
DOM hay còn hiểu là Document Object Model, là một cấu trúc dữ liệu biểu diễn cấu trúc XML hay HTML như dạng một cái dây, mỗi node của dây đó là một phần tử của trang web, và mỗi phần tử đó có thể chứa các phần tử con khác.
Bản chất DOM hiểu nôm na là một API cho phép người dùng tương tác với trang web thông qua các phần tử của trang web, và cũng là cơ sở để viết các script tương tác với trang web sử dụng các ngôn ngữ lập trình như Javascript.
Ví dụ như với một HTML như sau
<!DOCTYPE html>
<html>
<head>
    <title>Example</title>
</head>
<body>
    <h1>Hello, World!</h1>
    <p>This is an example.</p>
</body>
</html>
Thì DOM của nó là:
html
    head
        title
            "Example"
    body
        h1
            "Hello, World!"
        p
            "This is an example."
Tại sao DOM lại là một khái niệm bạn cần phải nắm? Vì Selenium tương tác với trình duyệt sử dụng Web Driver và dựa vào DOM đẻ tương tác với các phần tử của trang web. Và để tương tác với một phần tử thì phải xác định phần từ nào để làm, ví dụ như một JavaScript là
document.querySelector('h1').textContent = 'Hello, DOM!';
JavaScript này sẽ thay đổi nội dung của cái thẻ h1 thành Hello, DOM!, và ngay trong dòng code JavaScript chúng ta cũng thấy, dòng text đó được xác định bằng thẻ h1 với querySelector, và đó chính là một cách xác định locator của một element trong DOM
Khi sử dụng Selenium ,có tổng cộng 8 cách để xác định 1 element:
- ID:
driver.find_element_by_id('id') - Class Name :
driver.find_element_by_class_name('class') - Tag Name :
driver.find_element_by_tag_name('tag') - Name :
driver.find_element_by_name('name') - Link Text :
driver.find_element_by_link_text('link text') - Partial Link Text :
driver.find_element_by_partial_link_text('partial link text') - CSS Selector :
driver.find_element_by_css_selector('css selector') - XPath :
driver.find_element_by_xpath('xpath')
Thật ra với mình thì không có cách cụ thể nào để xếp 8 thằng này theo thứu tự ưu tiên cả, vì chung quy lại là:
- Ưu tiên CSS Selector hơn XPath vì nó nhanh hơn, tuy nhiên nếu chỉ có XPath mới tìm được thì triển\
- ID, Class Name, Tag Name, Name, Link Text, Partial Link Text là những cách xác định element cơ bản, dễ nhất, nhưng chúng nó về cơ bản cũng có thể được thực hiện bằng XPath, nên nếu XPath đang sử dụng chúng nó thì có thể chuyển sang dùng thay cho XPath
Ví dụ một Xpath là//input[@id='username']có thể được thay thế bằng idusername, cụ thể thì mình sẽ giải thích với ví dụ sau - Sẽ có một số trường hợp ảo ma khi mà cùng một element, Selenium tương tác được với CSS Selector nhưng không tương tác được với XPath, hoặc ngược lại, thì phải chấp nhận làm theo
What is XPATH
Xpath là một ngôn ngữ truy vấn dùng để tìm kiếm các phần tử xuất hiện ở trong một cấu trúc XML, và vì HTML cũng là một dạng XML nên XPath được sử dụng để tìm kiếm các phần tử trong HTML
Ví dụ, đây là xpath của thẻ h1 ở trên
/html/body/h1
Absolute Xpath vs Relative Xpath
Có hai loại XPath là Xpath tuyệt đối - Absolute Xpath và Xpath tương đối - Relative Xpath
XPath tuyệt đối thì đi từ gốc của cấu trúc DOM, tức là từ thẻ html đi xuống như ví dụ ở trên mình đưa ra, còn XPath tương đối thì đi từ một thẻ gần nhất, tức là từ thẻ h1 đi xuống như sau
//h1
Về cơ bản, khi sử dụng Xpath tương đối, nó sẽ đi từ mọi vị trí trong DOM làm gốc và trả ra tất cả các kết quả hợp với điều kiện. Xpath tuyệt đối thì khá cụ thể nhưng tính linh động không cao, dẫn tới một số điều sau mà mình muốn nói:
- Đầu tiên, rất hạn chế sử dụng Xpath tuyệt đối, vì trong các trang web hiện đại, cấu trúc DOM thường thay đổi khi ứng dụng Dynamic Web, đồng thời cấu trúc Xpath tuyệt đối cũng sẽ rất dễ gãy nếu như cấu trúc trang web được cập nhật
- Xpath tương đối luôn luôn là “must-go” do linh động, hiệu quả tương tự nhưng có khả năng tiết kiệm và ngắn hơn nhiều xpath tuyệt đối, đồng thời trong tình huống Dynamic Web thì còn có khả năng hoạt động tốt hơn Xpath tuyệt đối
Nếu bạn mà đi phỏng vấn, nhận câu hỏi lấy XPath, nếu lấy Xpath tuyệt đối thì tạch chắc, vì mặc định người không biết gì mới lấy xpath tuyệt đối
How To Catch XPath
Mình sẽ hướng dẫn bạn lấy XPath bằng tay, bản chất là có tồn tại các tool hỗ trợ lấy Xpath như là Chrome DevTool hay là SelectorHub, nhưng mà Xpath do chúng nó lấy ra thường không đi theo hướng tối ưu và cũng không linh động, không quan tâm đến tính toàn vẹn trong quá trình phát triển sản phẩm nên mình không khuyến khích dùng tool từ đầu. Sau này khi đã có kinh nghiệm làm việc với Xpath, bạn có thể dùng tool để lấy XPath, sau đó chỉnh sửa lại cho tối ưu và hợp với dự án
Đầu tiên, mở trang web mà cần lấy XPath, mình sẽ ví dụ là Chrome, sau đó bật Chrome DevTool, thường là F12 hoặc Ctrl + Shift + I, sau đó chọn tab Elements.
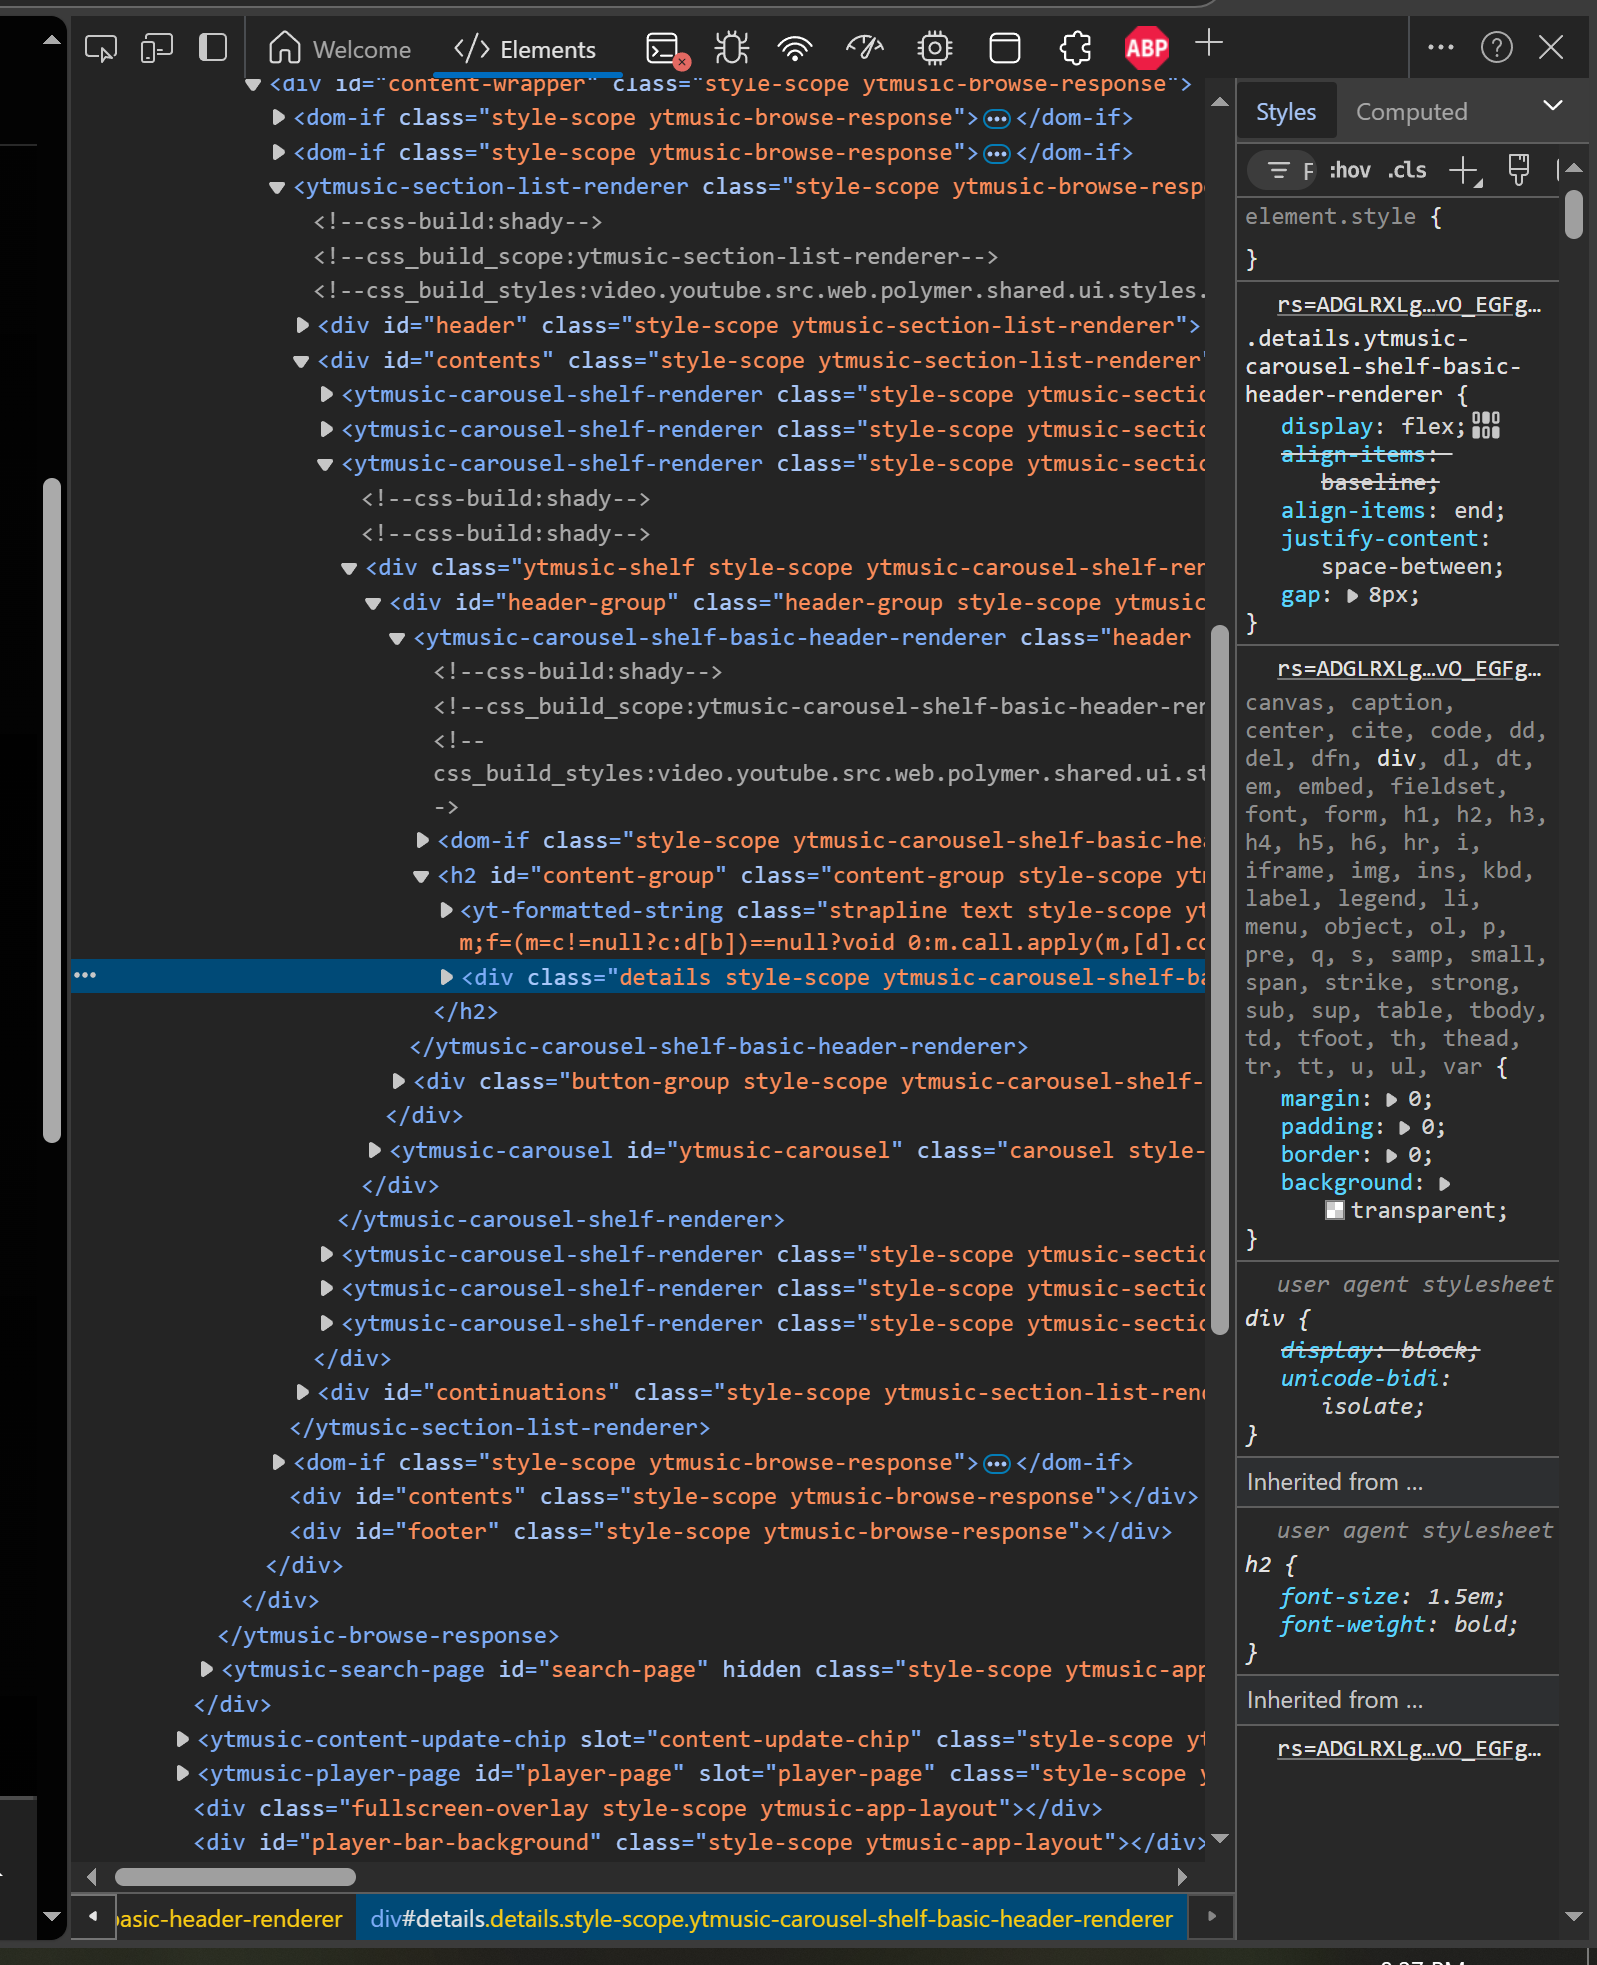
Giao diện Chrome DevTools
Hoặc bạn cứ chuột phải bừa một chỗ trên trang web rồi ấn Inspect
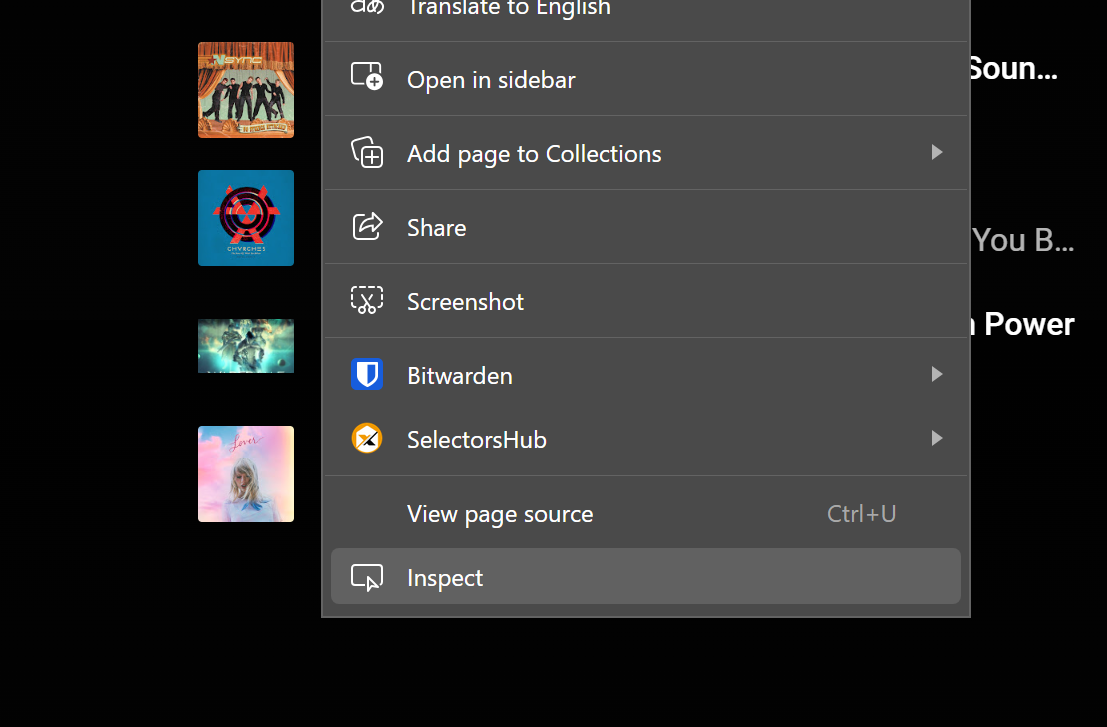
Lựa chọn Inspect khi chuột phải
Và sau đó, Ctrl F trong cửa sổ Elements và điền XPath, nếu có kết quả thì nó sẽ báo số lượng kết quả đồng thời highlight các element đó
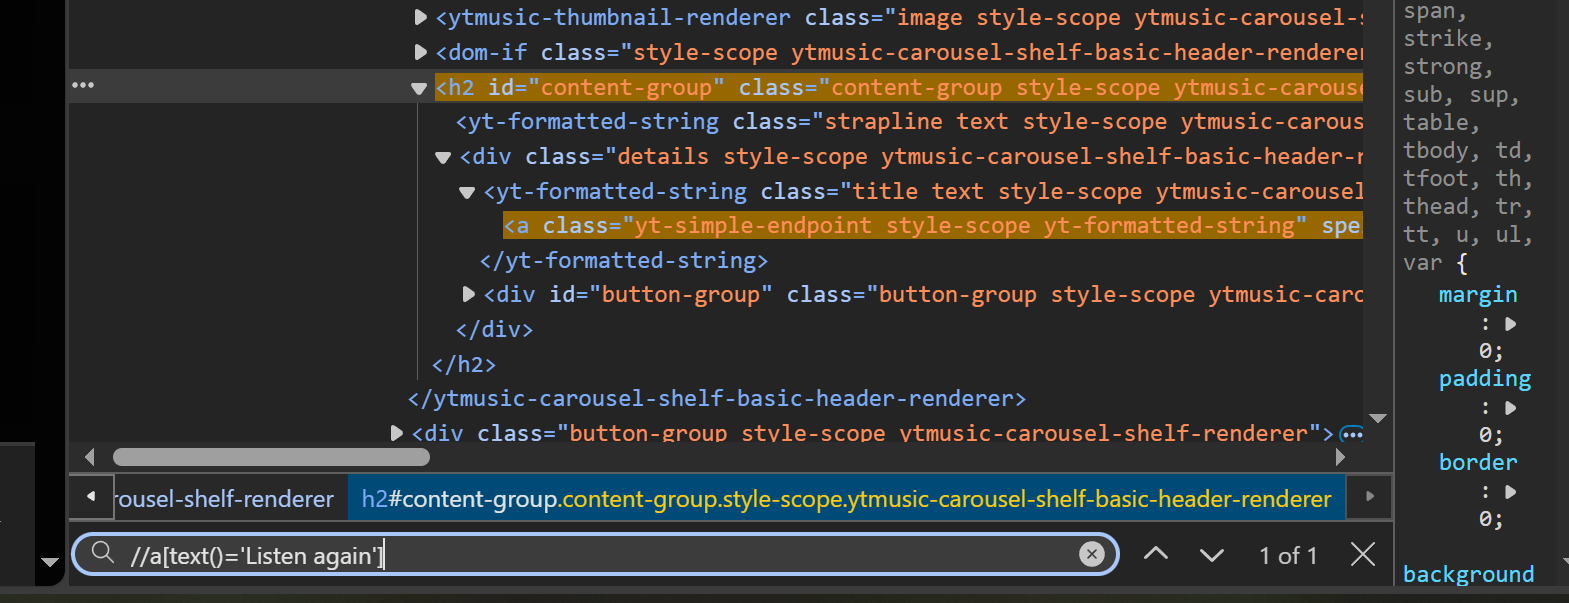
Tìm kiếm XPath
Xpath Syntax
Đầu tiên, XPath có 3 cách tìm:
- Tìm theo attribute của thẻ HTML:
//tag[@attributer = 'value'] - Tìm theo text của thẻ HTML (Nếu thẻ có text, text này phải nằm ngay trong thẻ):
//tag[text() = 'text'], chính như ví dụ ở trên mình đã dùngtext() - Tìm theo attribute hoặc text nhưng không cần chính xác:
//tag[contains(@attribute, 'value')]và//tag[contains(text(), 'text')]
Đồng thời, XPath có thể đi vào thẻ con từ một thẻ làm gốc hoặc đi lên thẻ cha từ một thẻ con, cụ thể có các dạng sau:
parent/child
//parent_tag/child_tag , nếu đi ngược lên thì là //child_tag/parent::parent_tag
Ví dụ với HTML sau:
<div class = "parent">
    <p class = "child">Text</p>
</div>
Chúng ta sẽ tìm thẻ p dựa vào thẻ div như sau : //div[@class='parent']/p[@class='child'] , ngược lại tìm thẻ div dựa vào thẻ p: //p[@class='child']/parent::div[@class='parent']
Hoặc thế này cũng được : //div[@class='parent']//p[@class='child'] và //p[@class='child']//parent::div[@class='parent']
Sự khác biệt giữa dùng một gạch / và 2 gạch // ở giữa xpath là gì?
Nếu chúng ta đang đi từ thẻ cao xuống thẻ thấp, thì dùng / tức là chúng ta đang tìm những thằng ở chính xác con trực tiếp của thằng cha, còn // thì chúng ta đang tìm những thằng ở bất kỳ vị trí nào trong thằng cha
Ví dụ với HTML sau:
<div class = "parent">
    <p>
        Text
        <p>Text</span>
    </p>
    <p>Text</p>
//div[@class='parent']/p sẽ trả ra 2 thẻ p, còn //div[@class='parent']//p sẽ trả ra 3 thẻ p, do khi sử dụng / thì chỉ có 2 thằng p đang là con trực tiếp, còn // thì sẽ trả ra tất cả thằng p trong div bao gồm cả thằng p con của thằng p
Nếu chúng ta đang đi từ thẻ thấp lên cao, thì dùng // hay / không quá quan trọng, thường thì số lượng kết quả sẽ chênh lệch 1. Dùng // thì sẽ tính cả bản thân thằng con, còn dùng / thì không
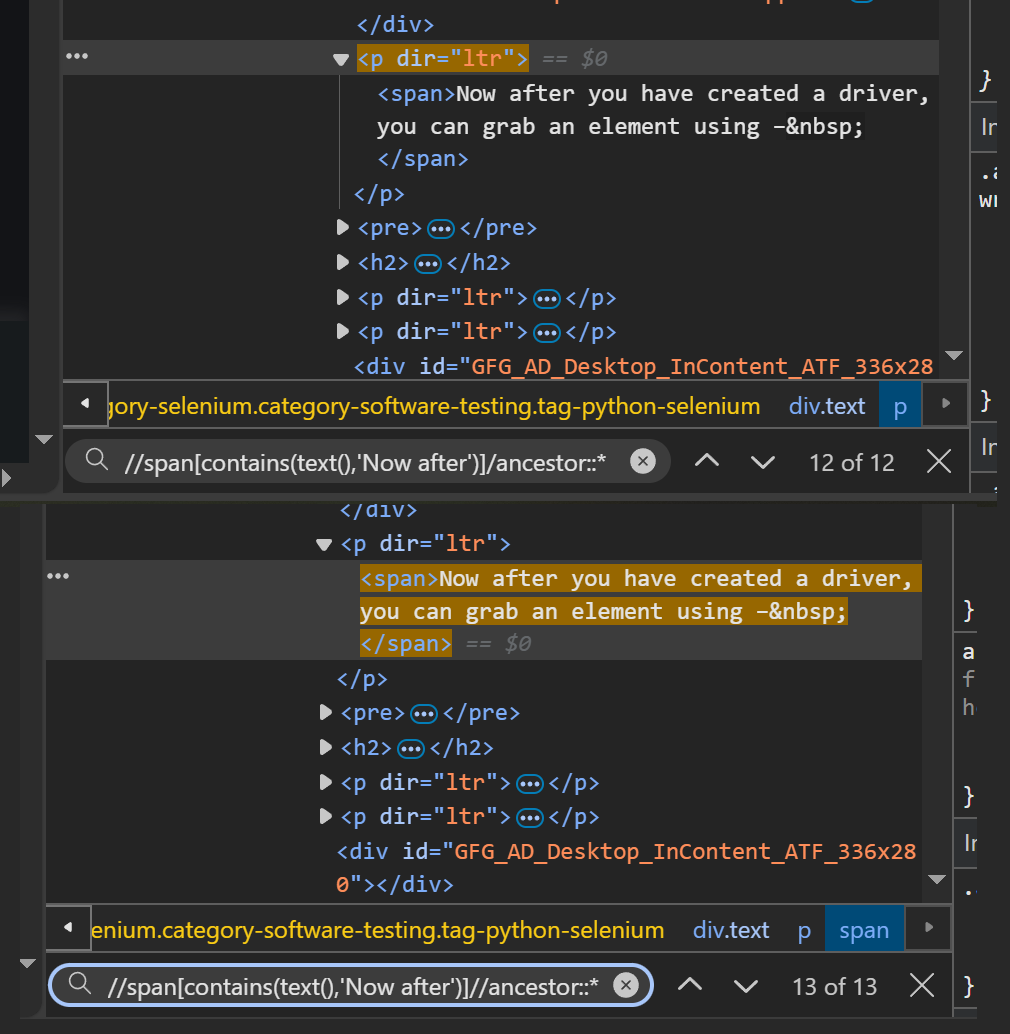
Khác nhau giữa `/` và `//`
descendant / descendant-or-self
descendant về cơ bản là tìm cháu của một thẻ html. Một thẻ cháu tức là miễn cứ nằm trong thẻ hiện tại, kể cả con trực tiếp hay không trực tiếp
Ví dụ với HTML sau:
<div id='ancestor'>
    <a>
        This is a
        <b>
            This is b
        </b>
    </a>
</div>
Cả thẻ <a> (vừa là con trực tiếp) và thẻ <b> đều là descendant của div, nhưng thẻ <b> không phải là con trực tiếp của div, đồng thời, <b> là con trực tiếp của <a> và cùng là descendant của <a>
Syntax descendant như sau:
//ancestor_tag/descendant::descendant_tag
Hay là
//ancestor_tag//descendant::descendant_tag
Với descendant thì việc sử dụng / hay // đều như nhau, vì descendant của một descendant cũng là descendant của thẻ lớn, khác với quan hệ parent/child khi mà child của một child không còn là child của thẻ lớn nữa
Với ví dụ ở trêm, có thể xác định thẻ <b> dưới danh nghĩa descendant của div như sau:
//div[@id='ancestor']/descendant::b
Hay cũng có thể dưới danh nghĩa descendant của a như sau:
//a/descendant::b
Đối với descendant-or-self thì đơn giản là tìm không chỉ descendant mà còn bản thân thẻ hiện tại, cú pháp cũng tương tự như descendant
//ancestor_tag/descendant-or-self::descendant_tag
Tuy nhiên, descendant-or-self chỉ có ý nghĩa nếu thẻ lớn có giá trị về mặt tìm kiếm và có đặc điểm tìm kiếm chung với các thẻ descendant, ví dụ như với HTML ở trên
<div id='ancestor'>
    <a>
        This is a
        <b>
            This is b
        </b>
    </a>
</div>
Cách duy nhất để xác định cả 3 thẻ là sử dụng * - tức là tìm tất cả
//div[@id='ancestor']//descendant-or-self::*
Ngoài ra, do thẻ lớn div không có liên quan gì đến các thẻ cháu, nên việc sử dụng descendant-or-self không có ý nghĩa gì cả
Kết quả của descendant và descendant-or-self đối với một thẻ cháu sẽ giống nhau
ancestor / ancestor-or-self
Nếu descendant là tìm các thẻ được gói trong thẻ cha (đầu và đuôi thẻ cha ở trên và dưới các thẻ cháu), thì ancestor là tìm các thẻ đang gói lại thẻ cháu (đầu và đuôi thẻ cháu nằm giữa đầu và đuôi thẻ cha)
Còn ancestor-or-self là tìm cả thẻ hiện tại, tương tự như cách descendant-or-self làm, nên mình sẽ không nói thêm
Với ancestor, cú pháp tương tự như descendant
//descendant_tag/ancestor::ancestor_tag
Vấn đề phát sinh chính là khi sử dụng ancestor thì / và // lại xuất hiện khác biệt. Kết quả trả ra của //descendant_tag//ancestor::ancestor_tag sẽ giống như ancestor-or-self
Ví dụ với HTML ở trên
<div id='ancestor'>
    <a>
        This is a
        <b>
            This is b
        </b>
    </a>
</div>
Chúng ta có thể xác định thẻ div dưới danh nghĩa ancestor của thẻ b như sau:
//b/ancestor::div
Sự khác biệt giữa / và // có thể thấy rõ khi chúng ta tìm tất cả, tức là *
//b//ancestor::*
Kết quả này trả ra 3, bao gồm cả thẻ b, a và div, tương tự như ancestor-or-self
//b/ancestor-or-self::*
Còn với //b/ancestor::* thì chỉ trả ra 2 thẻ a và div
Ngoài ra, với ancestor-or-self thì / hay // không khác biệt
following / preceding
following và preceding là tìm các thẻ xuất hiện sau và trước thẻ hiện tại. Cách dễ nhất để tưởng tượng là nhìn file html theo đường thẳng, quên hết indent đi
<div>
    <p>1</p>
    <p>2</p>
    <p>
        3
        <p>6</p>
    </p>
</div>
<p>4</p>
<p>5</p>
Thì ở đây, following của thẻ div sẽ là 4 và 5, còn preceding của thẻ div sẽ là không có gì, do không có một thẻ nào (cả đầu và đuôi) nằm trước đầu của thẻ div
following của thẻ 2 sẽ là 3, 6, 4, 5, còn preceding của thẻ 2 sẽ là 1
//tag/following::tag
//tag/preceding::tag
Với following và preceding, / và // không khác biệt
following-sibling / preceding-sibling
following-sibling và preceding-sibling ngoài việc tìm sau và trước như following và preceding tìm các thẻ cùng cấp với thẻ hiện tại, tức là thẻ có cùng thẻ cha (parent) với thẻ hiện tại.
Cũng với ví dụ trên, thì following-sibling của thẻ 2 sẽ là 3, còn preceding-sibling của thẻ 2 sẽ là 1.
following-sibling của thẻ 4 sẽ là 5, còn preceding-sibling của thẻ 4 sẽ là div
position và index
Ngoài ra, trong trường hợp không thể xác định chính xác từng thẻ do không có điểm khác biệt ngoài thứ tự xuất hiện, thì có thể sử dụng hoặc position() hoặc gói query vào () rồi truyền index như một list để xác định thẻ cần tìm
//div/p[position()=1]
(//div/p)[1]
Cả hai đều sẽ trả ra thẻ p đầu tiên của div